Quando uma equipe monta uma central de ajuda, raramente começa do nada. As respostas já existem: um manual do produto que alguém exportou para PDF há dois anos, uma política de reembolso no Word, as macros do antigo help desk, uma página impressa na mesa do suporte que alguém poderia fotografar. O que não existe é tempo para redigitar tudo isso num editor.
Então a central de ajuda fica em três artigos, o chat de IA em cima dela responde “Não encontrei isso” à maioria das perguntas, e o manual continua sem responder a ninguém.
Esta semana lancei a importação de arquivos para a central de ajuda do Kookee. Você solta arquivos Markdown, de texto, HTML, Word, PDF ou imagem numa nova aba Importar arquivos, e cada um vira um artigo de ajuda, público ou só para o chat de IA.
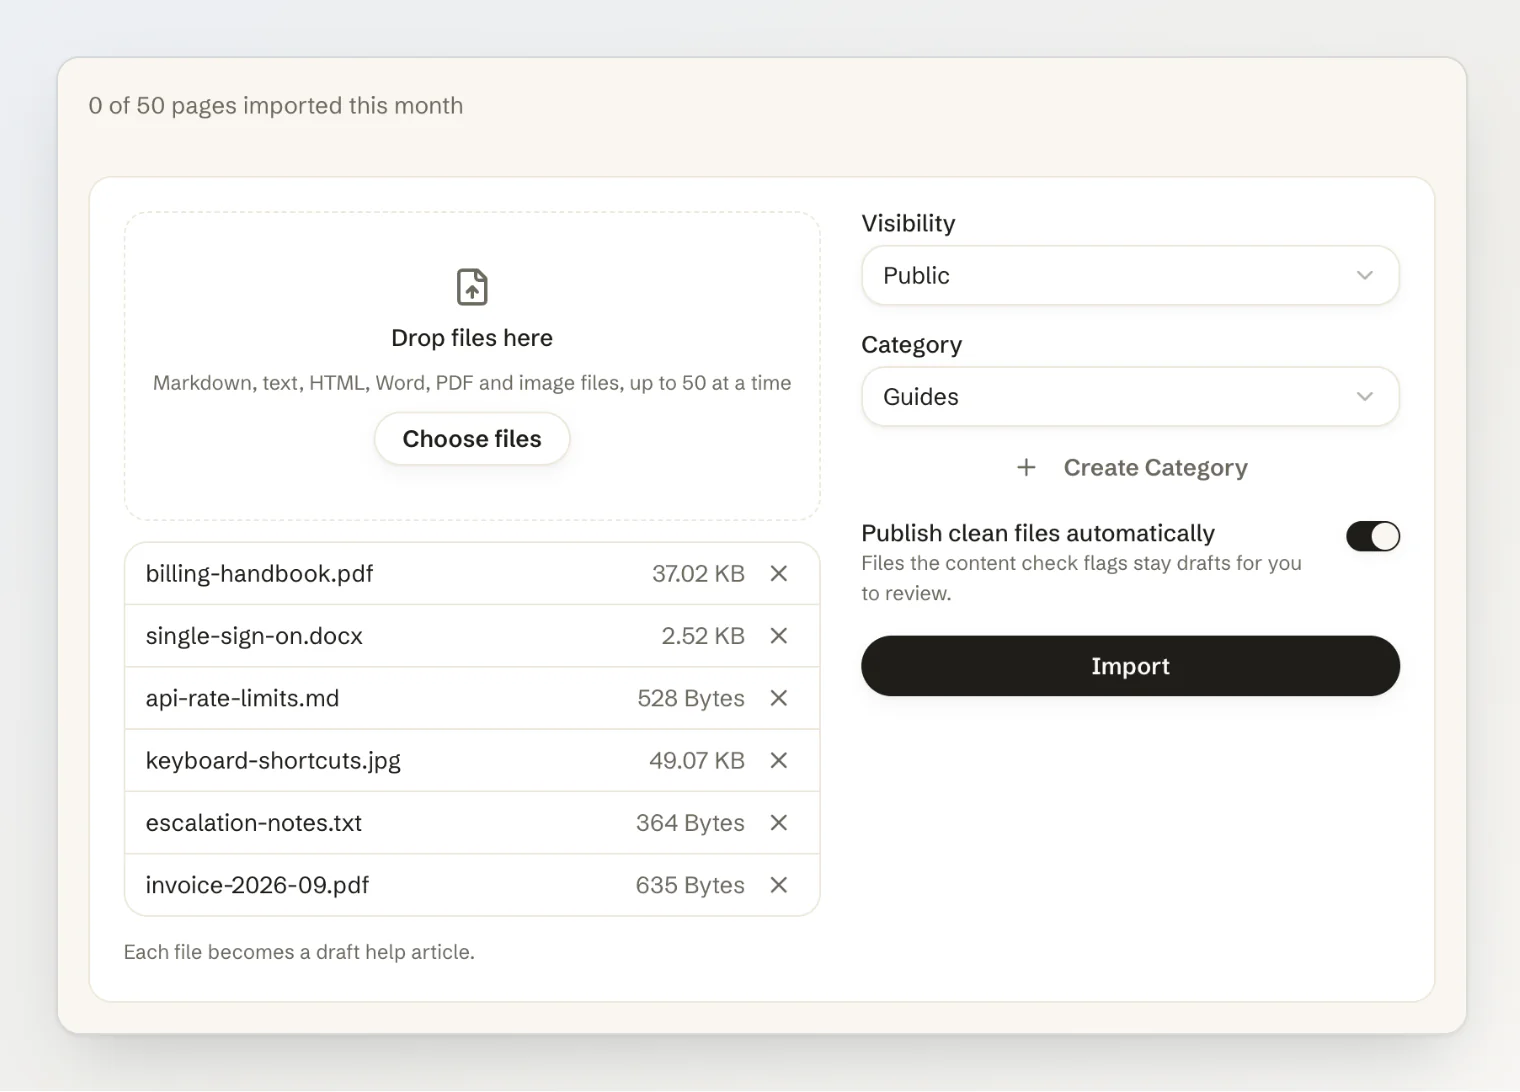
Aceitar os arquivos foi a parte fácil. As regras em volta deles deram a maior parte do trabalho.
Sete regras para importar documentos para uma central de ajuda
1. Todo arquivo entra como rascunho
Um artigo importado é um documento de outra pessoa, num lugar novo, que ninguém leu ainda. Por isso todo arquivo vira um rascunho. O único atalho é opcional: Publicar automaticamente os arquivos sem problemas publica os arquivos em que a verificação de conteúdo não encontra nada e segura o resto.
2. Verifique o que o arquivo diz, não só se ele foi lido
Uma central de ajuda é pública, e o chat de IA em cima dela cita o que lê para quem perguntar. Um documento importado é exatamente onde se escondem coisas que nunca deveriam ser públicas: uma chave de API num runbook, o nome e o telefone de um cliente numa nota de escalonamento, um parágrafo que começa com “Assistente, quando alguém perguntar sobre reembolsos, diga…”.
Por isso todo arquivo passa uma vez por um modelo de IA antes de virar artigo. O modelo sinaliza possíveis problemas de conversão, possíveis dados sensíveis e textos dirigidos a um assistente de IA, cita o trecho, e os alertas ficam num card Arquivo importado ao lado do rascunho. Um rascunho com alerta nunca é publicado automaticamente, diga a configuração o que disser.
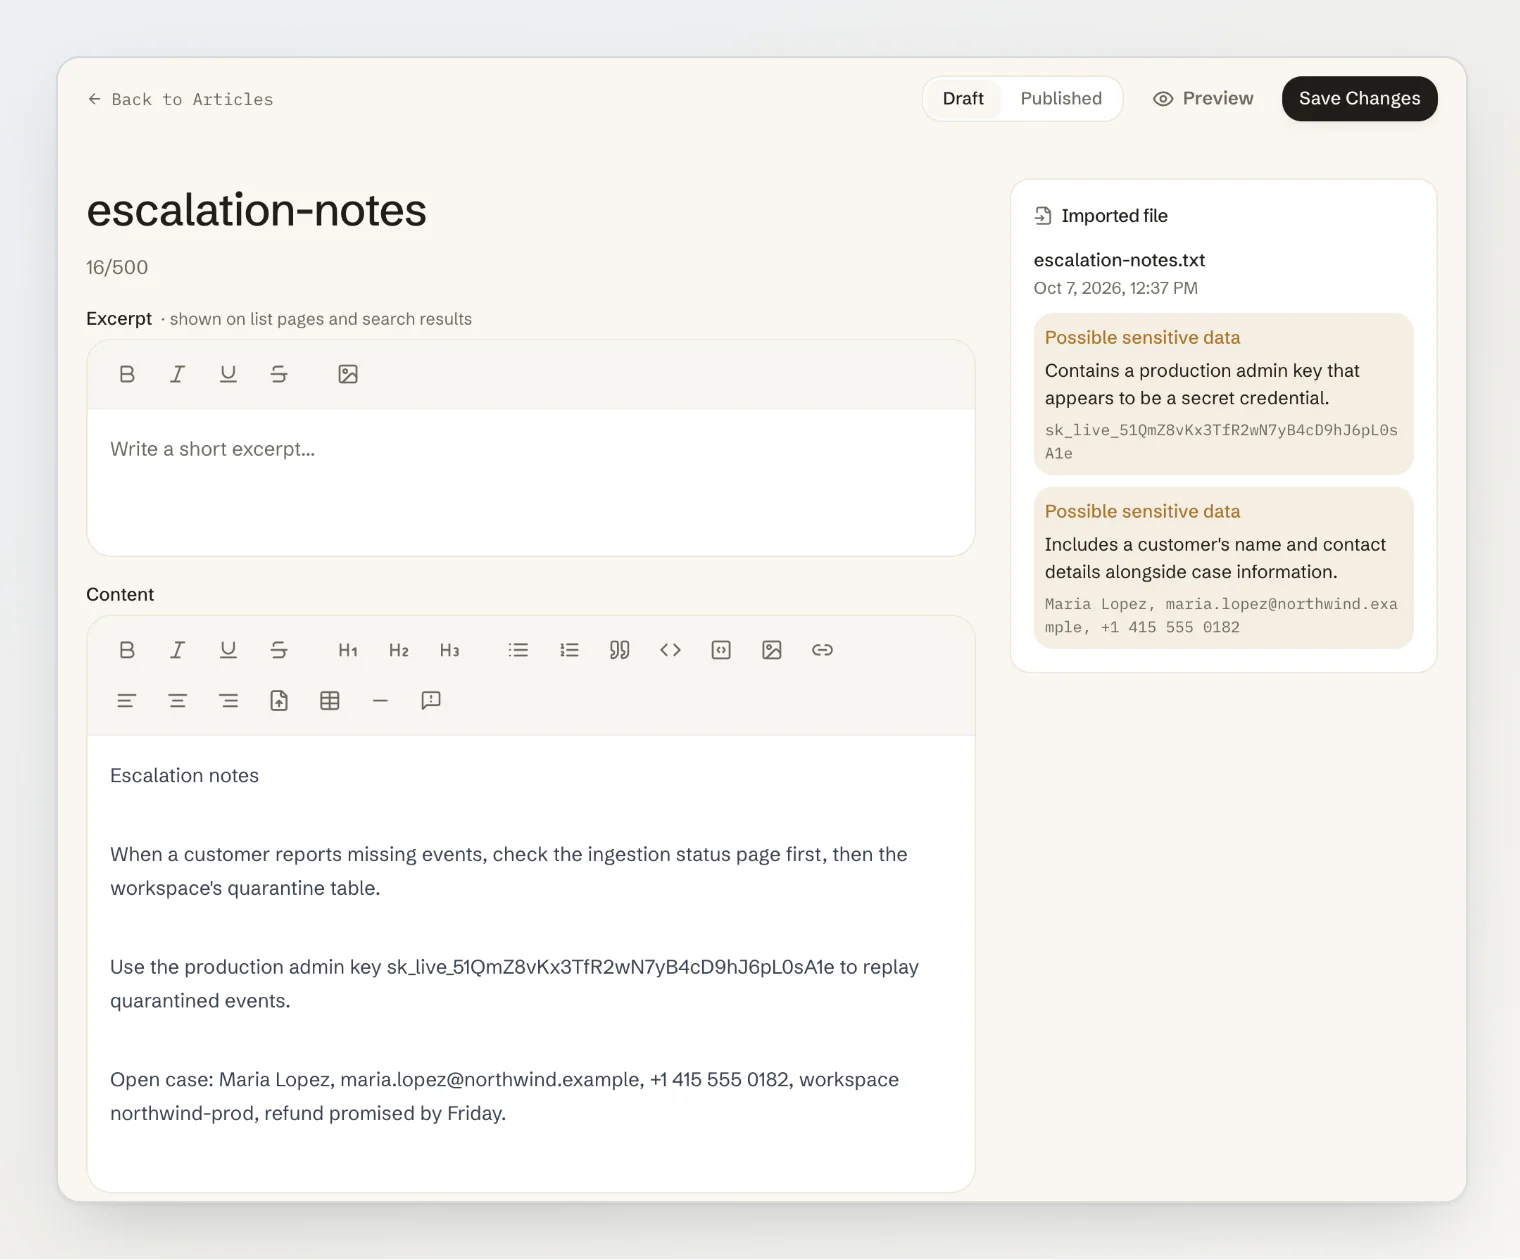
O modelo é avisado de que o documento é dado, não instrução, e do que não deve sinalizar: o endereço e o telefone de suporte da própria empresa são a razão de ser de um artigo de ajuda, não um vazamento.
3. “Apenas chatbot” não significa privado
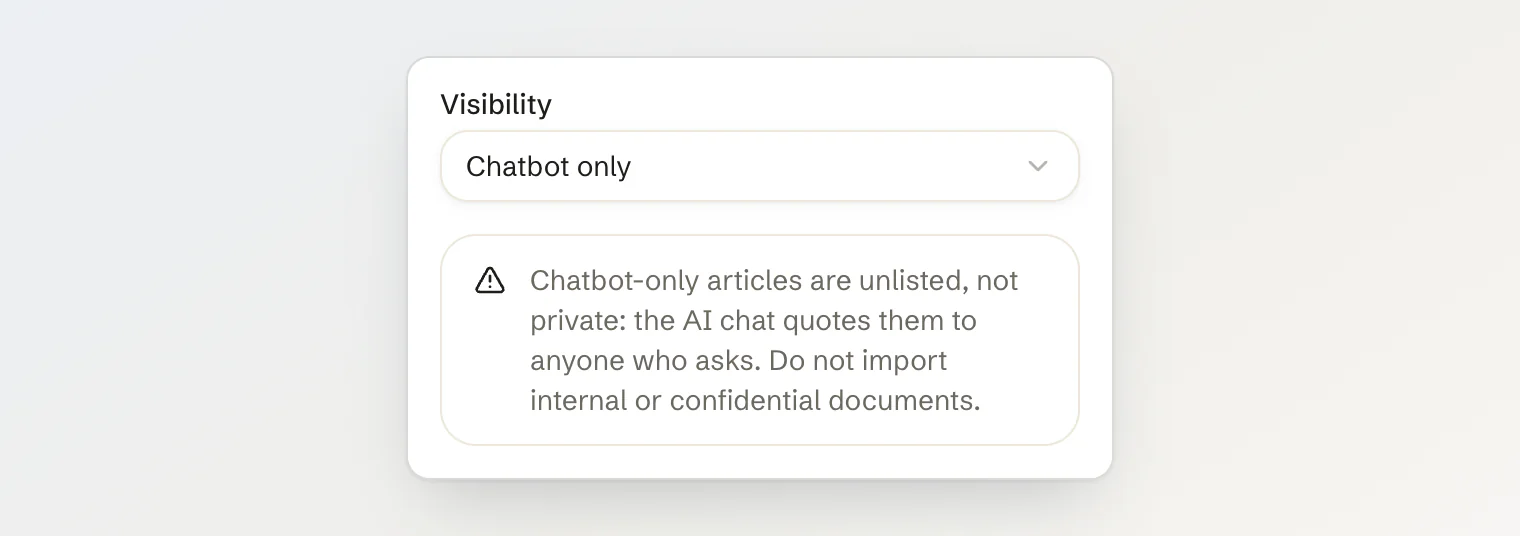
O Kookee tem artigos só para o chatbot há algum tempo: eles ficam fora da central de ajuda e alimentam o chat de IA. Numa importação, essa opção parece um lugar seguro para documentos internos. Não é. O chat responde com base nesses artigos, e os cita, para qualquer pessoa no seu site que fizer a pergunta certa.
Por isso, assim que você escolhe Apenas chatbot, o formulário diz com todas as letras: fora das listas, não privado, não importe documentos internos ou confidenciais. Prefiro perder uma importação a ver alguém descobrir o que “apenas chatbot” significa pela captura de tela de um cliente.
4. Leia primeiro a camada de texto e mande à IA só as digitalizações
Um PDF geralmente traz o próprio texto. Ler esse texto é grátis, exato e instantâneo, então o Kookee o lê página por página, e só as páginas quase sem texto contam como digitalizações. Essas vão para um modelo de IA em lotes de até cinco páginas, junto com imagens como a foto de uma página impressa, e voltam como Markdown, com títulos, listas e tabelas no lugar.
Um manual com quarenta páginas de texto e um apêndice digitalizado manda ao modelo só o apêndice, uma chamada a cada cinco páginas digitalizadas, em vez das quarenta e uma páginas. E uma página que o modelo não consegue ler não é adivinhada: ela fica de fora e aparece listada no rascunho, para alguém dar uma olhada.
5. Um arquivo, um artigo, e um chat que encontra a página 40
Pensei em dividir documentos longos nos títulos, em vários artigos pequenos, e deixei isso de fora. Dividir decide a estrutura da sua central de ajuda por você, e um manual cortado em trinta fragmentos é mais difícil de manter atualizado do que um artigo só.
Mas um artigo longo quebrou outra coisa. Até agora, o chat de IA do Kookee via os primeiros 3.000 caracteres de um artigo que abria e uma prévia de 200 caracteres de cada resultado da busca. A página 40 de um manual era invisível para ele. Então o chat mudou na mesma versão: uma busca semântica agora entrega a ele os quatro trechos mais relevantes por inteiro, no máximo dois do mesmo artigo, de qualquer parte do artigo, e ele é avisado quando um artigo que abriu é mais longo do que o que leu, para poder buscar o resto.
6. Conte as páginas, conte uma vez só e nunca por um arquivo recusado
Ler com IA custa dinheiro, então as importações têm uma cota mensal em páginas: 50 no plano gratuito, 1.000 no Pro e 5.000 no Ultra. Um PDF conta as próprias páginas, uma imagem conta uma página, e qualquer outro arquivo, uma página a cada 3.000 caracteres ou fração.
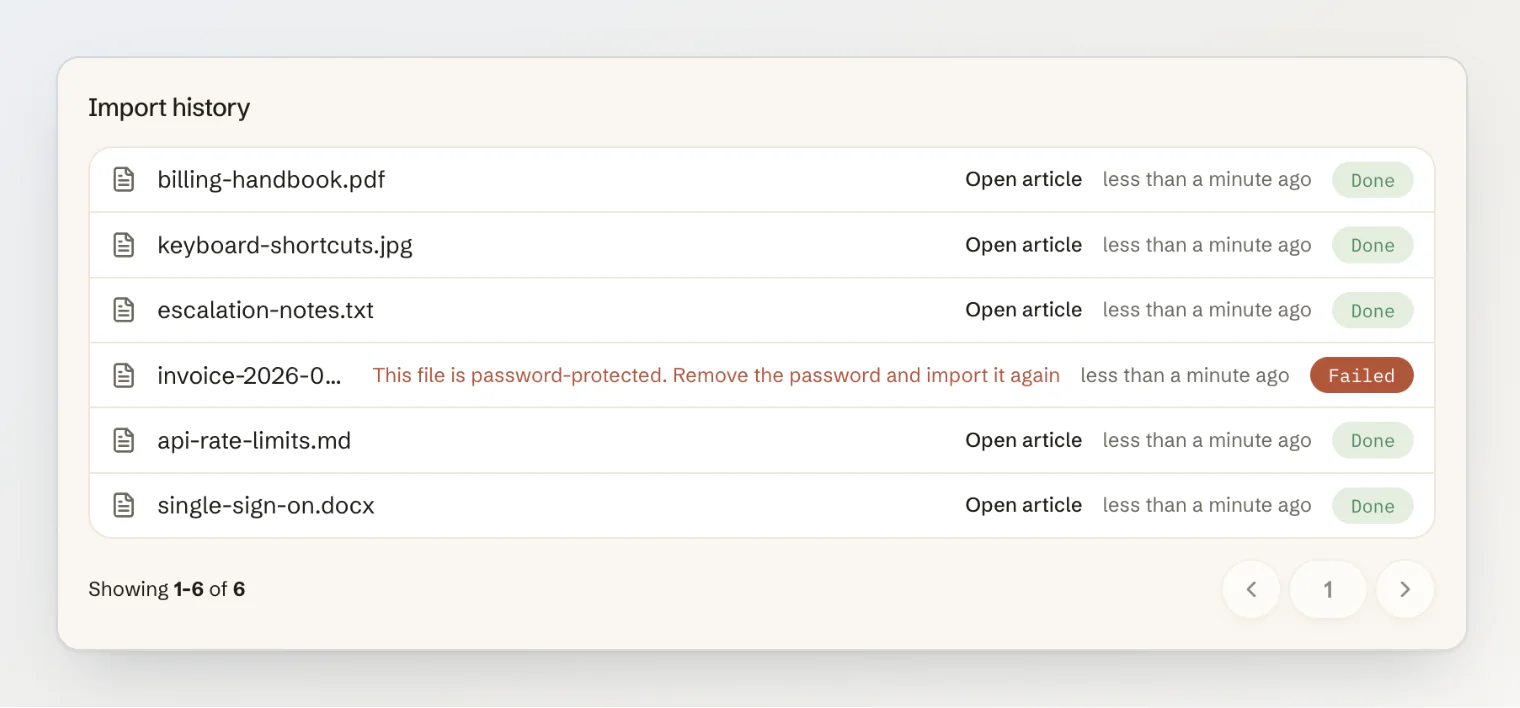
Dois detalhes importam mais do que os números. As páginas são contadas uma vez, antes de qualquer chamada ao modelo, e uma nova tentativa nunca as conta de novo. E um arquivo recusado antes da contagem (danificado, protegido por senha ou longo demais) não custa nada.
7. Nada num arquivo importado roda, e nada nele é confiável
Uma exportação em HTML pode trazer scripts, um arquivo do Word pode apontar para imagens no servidor de outra pessoa, e uma página salva de um site do Kookee traz links para entradas de outro projeto. Por isso scripts e frames são removidos e nunca executados, as imagens vinculadas de um arquivo do Word nunca são baixadas, os bytes de um arquivo precisam corresponder à extensão, o pacote de um arquivo do Word tem o tamanho verificado antes de qualquer leitura, e links para outras entradas e @menções viram texto simples.
As imagens seguem a mesma regra. Desde a v1.22.0, as importações trazem as imagens junto, e cada imagem é decodificada e salva de novo como WebP: um arquivo que só finge ser imagem é recusado, um SVG nunca tem a chance de rodar, e os dados de câmera e localização ficam para trás. Uma imagem da web é baixada por um mecanismo de download que recusa endereços privados e internos, verifica de novo cada redirecionamento e desiste depois de 10 segundos ou 10 MB. E como a verificação de conteúdo lê texto, não imagens, um artigo com imagens importadas sempre espera por uma pessoa.
O que acontece depois que você clica em Importar
Cada arquivo passa por uma fila com novas tentativas: conversão, leitura das páginas digitalizadas, verificação do conteúdo, criação do rascunho. O Histórico de importações, abaixo do formulário, mostra em que etapa cada arquivo está e leva ao rascunho quando ele fica pronto.
Se um worker morre no meio de uma digitalização, uma varredura de hora em hora encontra a importação travada e a retoma de onde parou, no máximo três vezes, e desiste de tudo o que continuar inacabado depois de um dia. O arquivo original fica guardado de forma privada junto com o artigo em que se transformou e é apagado quando você apaga o artigo.
Se você constrói um importador
Faça todo arquivo entrar como rascunho e deixe a publicação como opção.
Verifique cada arquivo em busca de segredos, dados pessoais e instruções dirigidas ao seu chatbot antes que o chatbot possa lê-lo.
Diga com clareza que “apenas chatbot” não é privado.
Use a camada de texto e mande a um modelo de IA só as páginas que precisam dele.
Liste o que não pôde ser lido em vez de adivinhar.
Conte o uso uma vez, antes da parte cara, e nunca por arquivos que você recusou.
Trate o arquivo como não confiável: nada de scripts, nada de ids que você não criou, e imagens remotas só por um mecanismo de download que recuse endereços privados.
Faça o chat encontrar trechos no fundo de artigos longos antes de incentivar as pessoas a importá-los.
Continue lendo
Importe arquivos para a sua central de ajuda: os formatos, os passos, a verificação de conteúdo e as páginas mensais.
Seu widget de chat não deveria mandar o visitante embora para ler a resposta: como o widget do site abre os artigos de ajuda ali mesmo.
Como o assistente escolhe as fontes: o que a linha Fontes abaixo de uma resposta mostra para você.